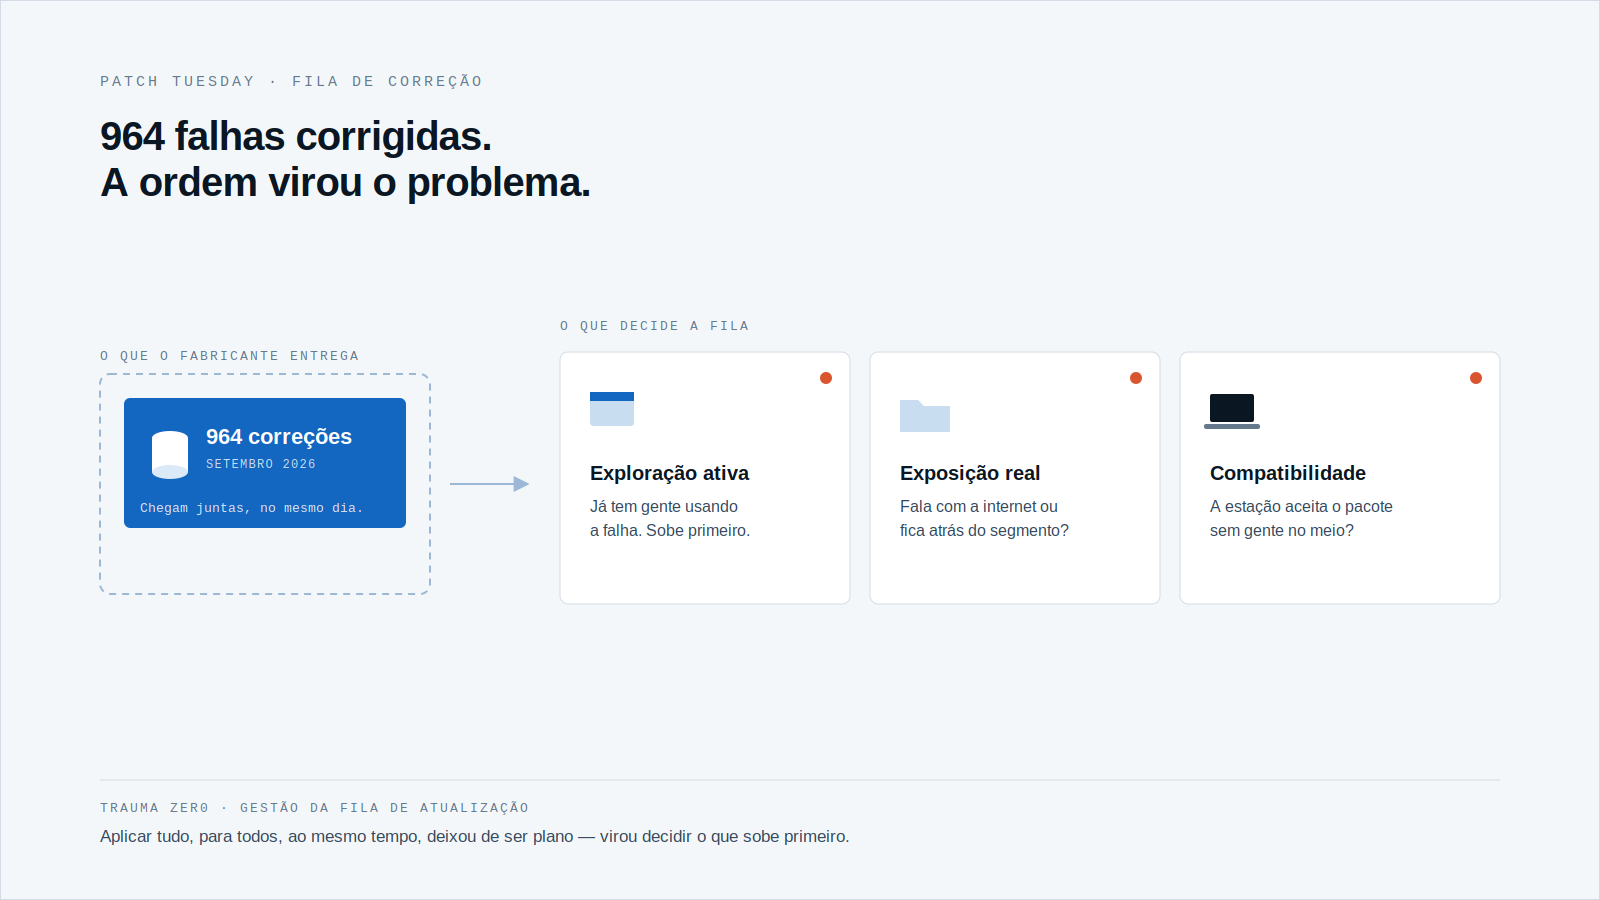
El 8 de septiembre de 2026 Microsoft lanzó el Patch Tuesday más grande de su historia: 964 vulnerabilidades corregidas en un solo lote, 104 de ellas clasificadas como críticas, según el conteo de Tenable. Dos ya se estaban explotando en ataques antes de que saliera la corrección.
Para una operación con unos cientos de equipos, aplicar todo en un fin de semana es trabajoso, pero se puede. Para quien administra varios miles de estaciones, repartidas entre sedes y áreas, en una red que no habla libremente con internet, corregir todo de una vez dejó de ser un plan realista.
La pregunta que queda no es «vamos a actualizar». Es qué va primero — y cómo se prueba después que realmente se aplicó.
Un volumen que la clasificación manual ya no aguanta
Septiembre no fue un pico aislado. La propia Microsoft cerró julio de 2026 con 570 correcciones y agosto con 400, según BleepingComputer, que sigue cada lanzamiento mensual de la compañía. El lote de septiembre más que duplicó el promedio de los dos meses anteriores.
De las 964 correcciones de septiembre, Tenable contó 104 críticas — 81 de ejecución remota de código, 20 de elevación de privilegios, entre otras categorías. Y dos fallas, CVE-2026-81963 y CVE-2026-85880, ambas de elevación de privilegios en el núcleo de Windows, ya se estaban explotando antes de que existiera la corrección.
Ningún equipo aplica 964 correcciones en una sola madrugada, en miles de equipos, sin romper algo en el camino. La pregunta dejó de ser si corregir todo. Pasó a ser decidir, con un criterio, qué sube primero.
Qué decide el orden de la cola
- Explotación activa: ¿ya alguien está usando la falla, o el riesgo sigue siendo teórico?
- Exposición real: ¿el equipo habla con internet, o está detrás de un segmento controlado?
- Criticidad del activo: ¿es la estación de un analista, o el servidor que sostiene la operación?
- Camino de ataque: ¿la falla exige acceso físico al equipo, o basta un clic remoto?
Corregir todo, al mismo tiempo, para todos, dejó de ser un plan. Se convirtió en un deseo.
Sin ese criterio, el parque grande actualiza por orden de llegada — o por la urgencia del día. Es la receta para dejar una falla ya explotada, como las dos de septiembre, esperando detrás de otra sin gravedad alguna, solo porque su paquete llegó primero a la cola del equipo.
Es ese tipo de ventana abierta la que, si un atacante entra antes de que llegue la corrección, deja la misma pregunta que queda después de un rescate de ransomware pagado: ¿qué pasó, exactamente, en cada equipo tocado, mientras la falla estuvo expuesta?
En una red segmentada, la cola es más grande que la lista de CVE
Tener el criterio correcto resuelve la mitad del problema. La otra mitad es logística: cómo sale la corrección del repositorio y llega a cada estación sin frenar el trabajo de quien la está usando.
En una red corporativa grande, eso significa programar por grupo — una sede a la vez, un turno a la vez —, controlar el ancho de banda para no competir con el sistema que sostiene la operación, y contar con caídas de conexión a mitad de la transferencia, que necesitan retomar desde donde quedaron, no empezar de cero.
Esa es la realidad operativa detrás de la gestión de un parque on-premise: la distribución tiene que caber en la red que realmente existe, no en la que asume el fabricante. Lo que cabía en una madrugada hace un año hoy toma días con el parque actual.
Y hay un detalle que la lista de CVE por sí sola no muestra: cuántas de esas miles de estaciones son hoy compatibles para recibir el paquete sin intervención manual previa.
La cola se cerró. ¿Quién prueba que se cerró de verdad?
El comunicado de Microsoft cierra la obligación del fabricante. No cierra la obligación de quien opera el parque.
Auditoría interna, aseguradora y, en algunos sectores, el regulador, no preguntan si existió el Patch Tuesday de septiembre. Preguntan si cada equipo de la lista recibió la corrección — y, si no la recibió, desde cuándo está expuesto.
Sin un registro por equipo, como el que mantiene la pantalla de actualizaciones de Tz0 Deploy, la respuesta se convierte en estimación. Con el volumen de hoy, «la mayoría debería haberse actualizado» ya no es ninguna garantía — es la definición de lo que todavía falta corregir.
Cómo Tz0 Deploy maneja la cola de corrección
Tz0 Deploy organiza esa cola en cinco pasos: empaquetar la corrección, definir el objetivo por grupo — área, sede, tipo de equipo —, programar la ventana, distribuir y verificar quién la instaló, con reprogramación automática para quien falló.
La instalación corre en silencio, sin interrumpir a quien está usando el equipo. La ventana puede ser de madrugada, fin de semana o inmediata, con control de ancho de banda para no competir con un sistema crítico, y reanudación automática cuando la conexión cae a mitad de la transferencia — el escenario habitual en una red grande y segmentada.
El mismo proceso cubre escritorios, portátiles y servidores, en Windows, Linux y Android, con un catálogo de más de 12 mil paquetes ya listos para distribuir. El panel muestra, por equipo, qué está pendiente y qué es corrección de seguridad — la respuesta lista para cuando la auditoría pregunte si la cola de septiembre realmente se cerró.
La próxima cola ya viene en camino
Septiembre de 2026 no fue una excepción. Fue el tercer mes seguido en que subió el número de correcciones, y nada indica que octubre vaya a revertir eso.
La pregunta que queda no es si va a llegar el próximo Patch Tuesday. Es si, cuando llegue, su operación sabe qué equipo ya recibió qué — o está estimando.
Solicite una evaluación de Trauma Zer0 y vea cómo está hoy la cola de corrección de su parque.